Sentiment Classification for NPS Data:

An Approach with Hybrid Models and Transfer Learning

Byron Vinueza

2025-12-18

Agenda

  1. Introducción y Contexto
    • ¿Qué es NPS?
    • Objetivos del proyecto
  2. Flujo del Proyecto
    • Pipeline del procesamiento
  3. Distribución de clases
    • Dataset y su distribución
    • Técnicas de balanceo.
  1. Arquitecturas
    • LSTM Bidireccional + Attention
    • Lematización + Baseline
    • Modelo Híbrido
    • Fine-Tuning con BETO
  2. Resultados y Evaluación
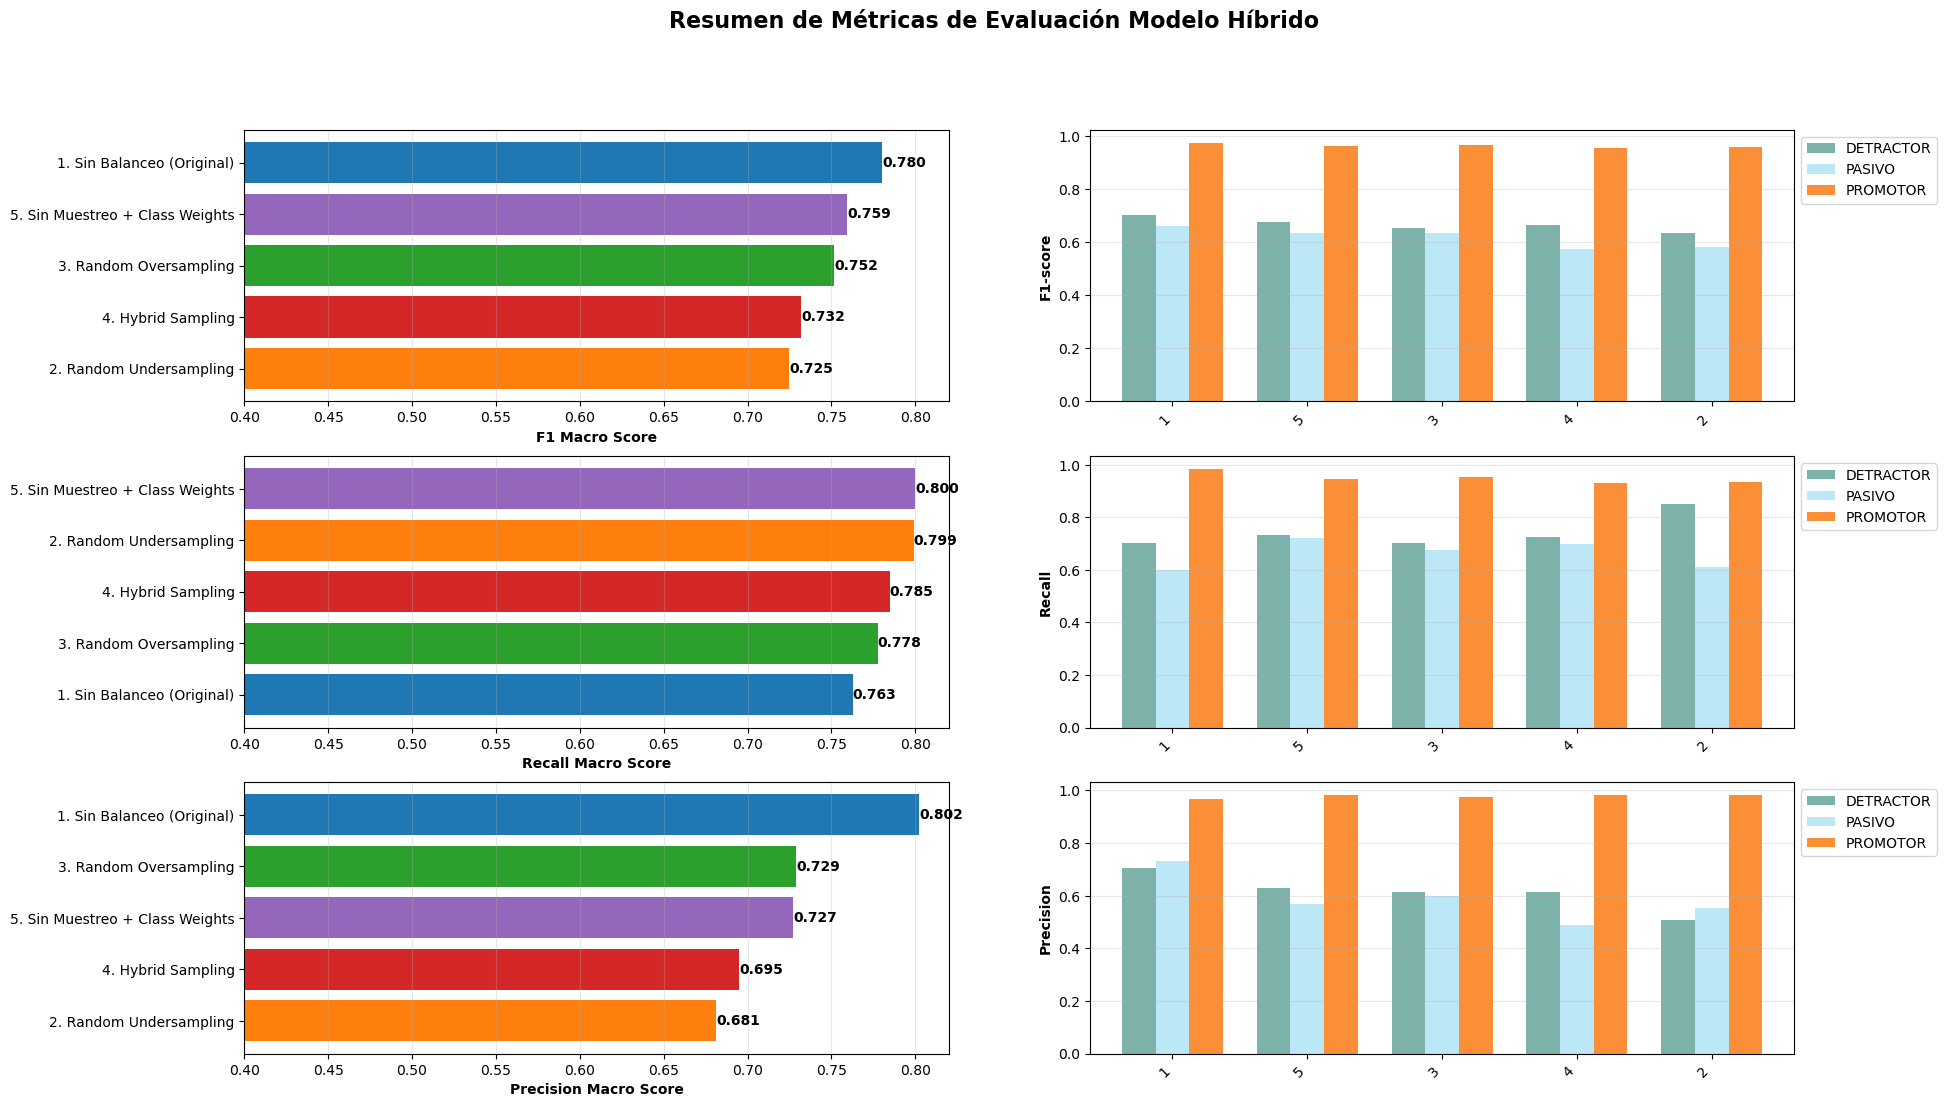
    • Comparación de técnicas
    • Métricas de rendimiento
  3. Conclusiones y Recomendaciones
    • Resumen de hallazgos

¿QUÉ ES NPS?

¿Qué es NPS?

Net Promoter Score (NPS)

  • Métrica de satisfacción del cliente.
  • Escala de 0 a 10
  • Tres categorías:
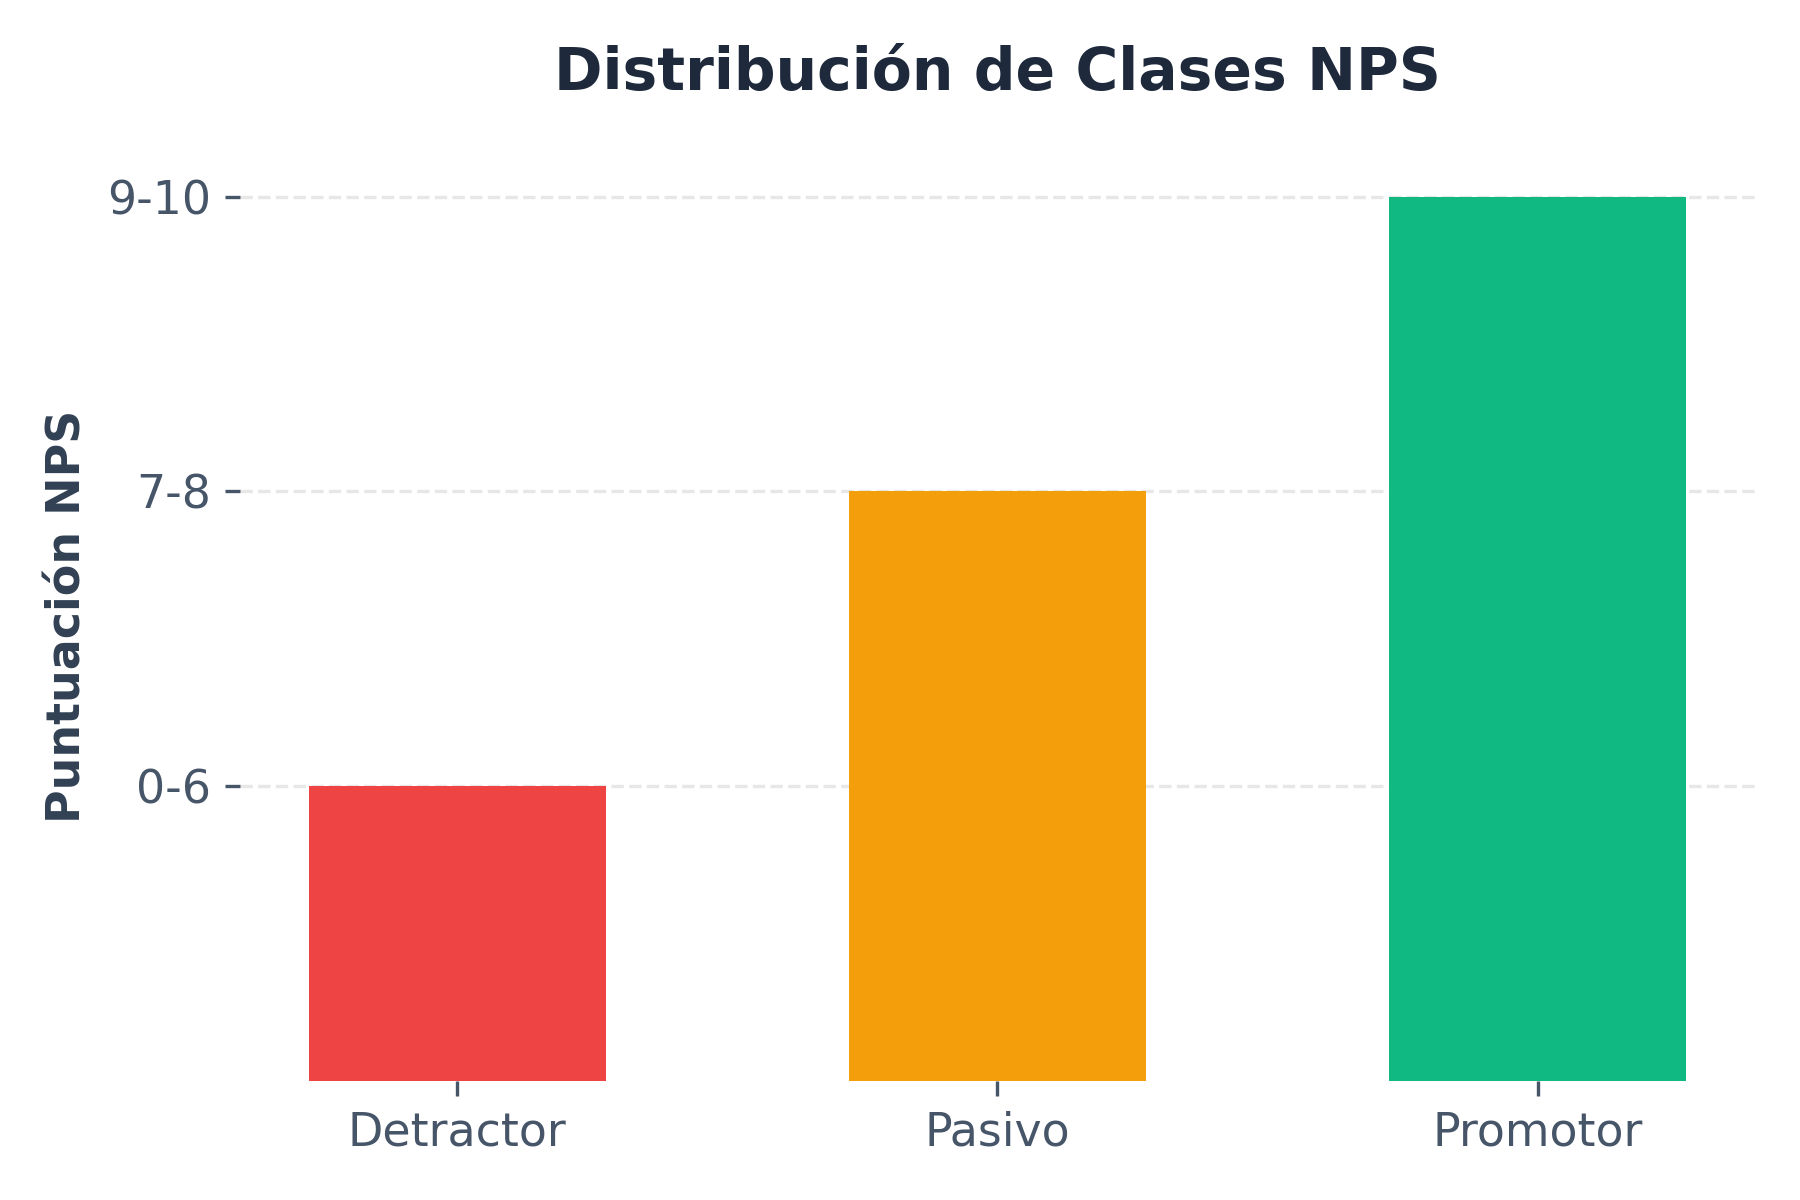
    • Detractores (0-6)
    • Pasivos (7-8)
    • Promotores (9-10)

Importancia

  • Los comentarios de los clientes son fundamentales para entender las razones detrás de sus puntuaciones NPS.
  • Mide la lealtad y satisfacción del cliente, proporcionando insights valiosos para mejorar productos y servicios.

OBJETIVOS

Objetivos del Proyecto

Objetivo Principal

  • El objetivo es construir un modelo de clasificación robusto y generalizable con alta sensibilidad (Recall) para la clase Detractor, minimizando los falsos negativos y apoyando el flujo de trabajo de resolución de quejas.

Objetivos Específicos

  • Explorar técnicas avanzadas de procesamiento de lenguaje natural (NLP) para mejorar la precisión de la clasificación de sentimientos en datos de NPS.

  • Implementar y comparar modelos híbridos y enfoques de aprendizaje por transferencia para optimizar el rendimiento del modelo.

  • Evaluar el impacto de diferentes técnicas de balanceo de datos en la sensibilidad del modelo hacia la clase Detractor.

FLUJO DEL PROYECTO

Pipeline de Procesamiento

%%{init: { "flowchart": { "nodeSpacing": 15, "rankSpacing": 20 }}}%%
flowchart TD 
    A["Extracción de Datos"] --> B["Preprocesamiento GPT"]
    B --> C["Análisis Exploratorio "]
    C --> D["Modelo  - Arquitectura "]
    D --> E["Entrenamiento
    del Modelo"]
    E --> F["Evaluación y 
    Validación"]
    F --> D
    
    style A fill:#e0e7ff,stroke:#4f46e5,stroke-width:1px
    style B fill:#fef3c7,stroke:#f59e0b,stroke-width:1px
    style C fill:#dbeafe,stroke:#3b82f6,stroke-width:1px
    style D fill:#e0f2fe,stroke:#0ea5e9,stroke-width:1px
    style E fill:#dcfce7,stroke:#10b981,stroke-width:1px
    style F fill:#d1fae5,stroke:#059669,stroke-width:1px

Paso Clave: Preprocesamiento con IA

  • 🤖 OpenAI GPT-3.5 para corrección automática de texto
  • ✍️ Corrección de ortografía y gramática

Impacto del Preprocesamiento

  • Mejoró significativamente la calidad de los datos de entrada antes del análisis.

EXPLORACIÓN DE DATOS

Distribución de clases


Table 1: Distribución de clases por técnica de balanceo
Técnica Total Detractor Pasivo Promotor
Sin balanceo 69,923 3,473 6,030 60,420
Undersampling 10,419 3,473 3,473 3,473
Oversampling 181,260 60,420 60,420 60,420
Hybrid (U=0.3, O=0.8) 47,126 14,500 14,500 18,126

ARQUITECTURAS DE MODELOS

Baseline

LSTM Bidireccional + Attention

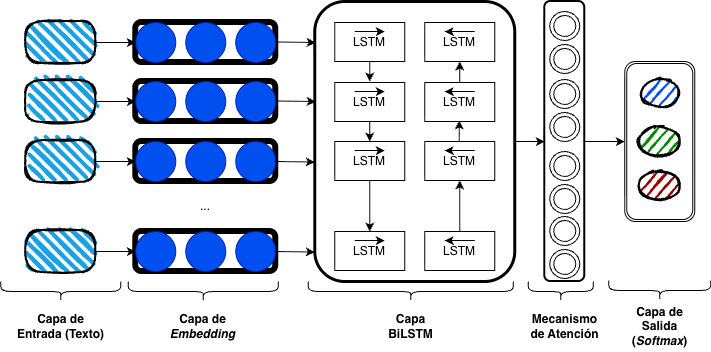
  • Capa de embedding El texto de entrada se convierte en vectores de embedding usando Word2Vec.
  • LSTM bidireccional Captura dependencias contextuales en ambas direcciones
  • Mecanismo de atención Permite al modelo enfocarse en palabras clave relevantes para la clasificación.

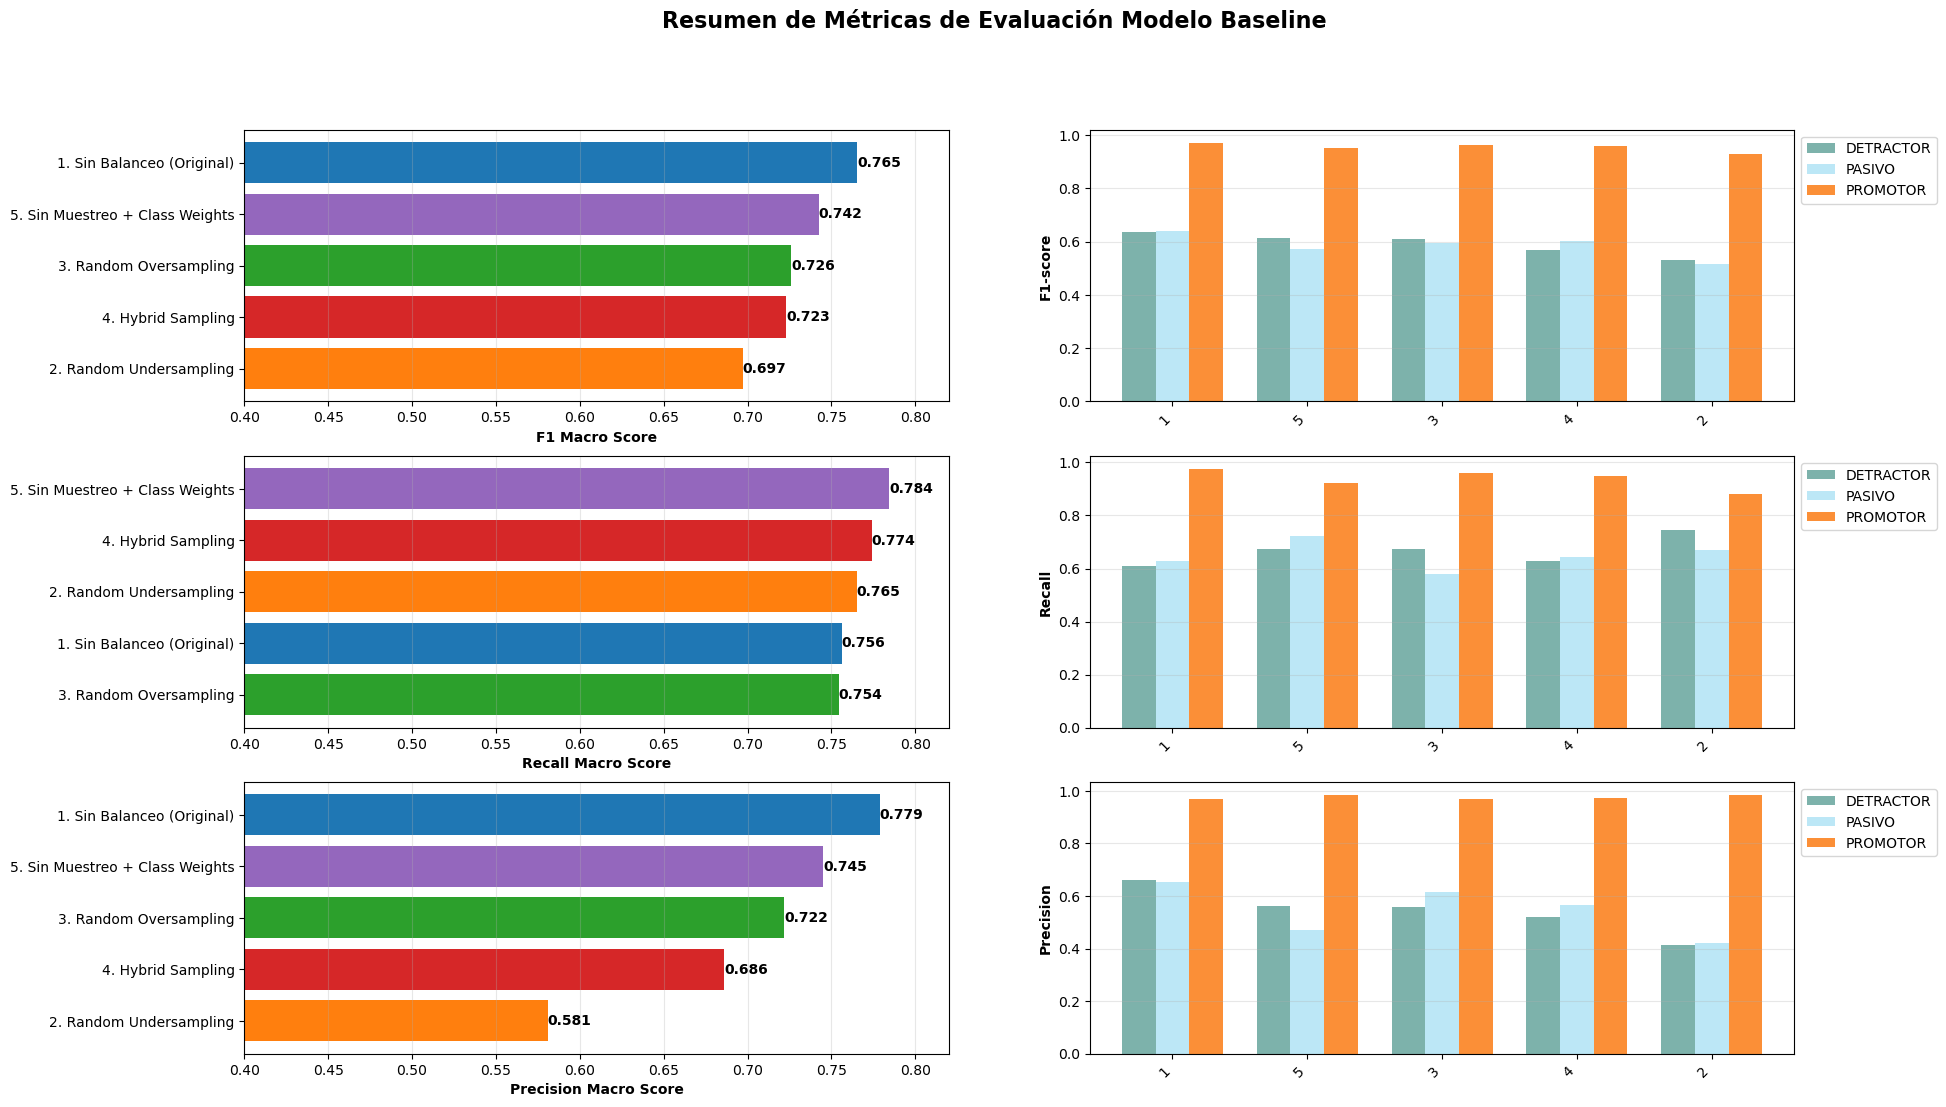
Métricas Baseline

Lematización + Baseline
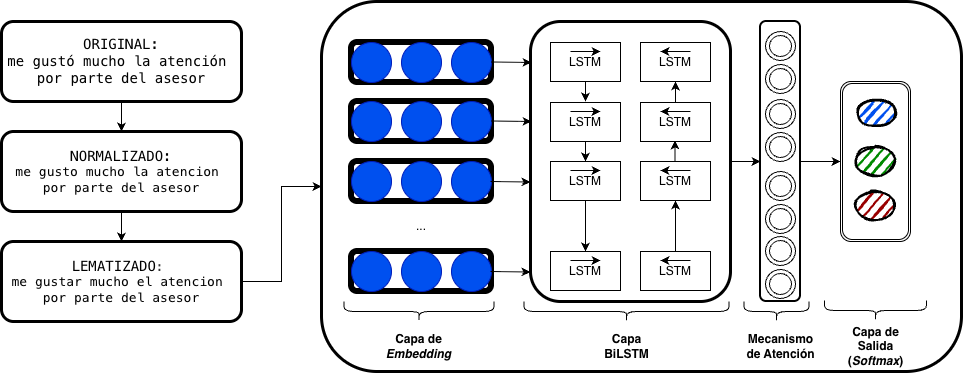
Lematización + Baseline

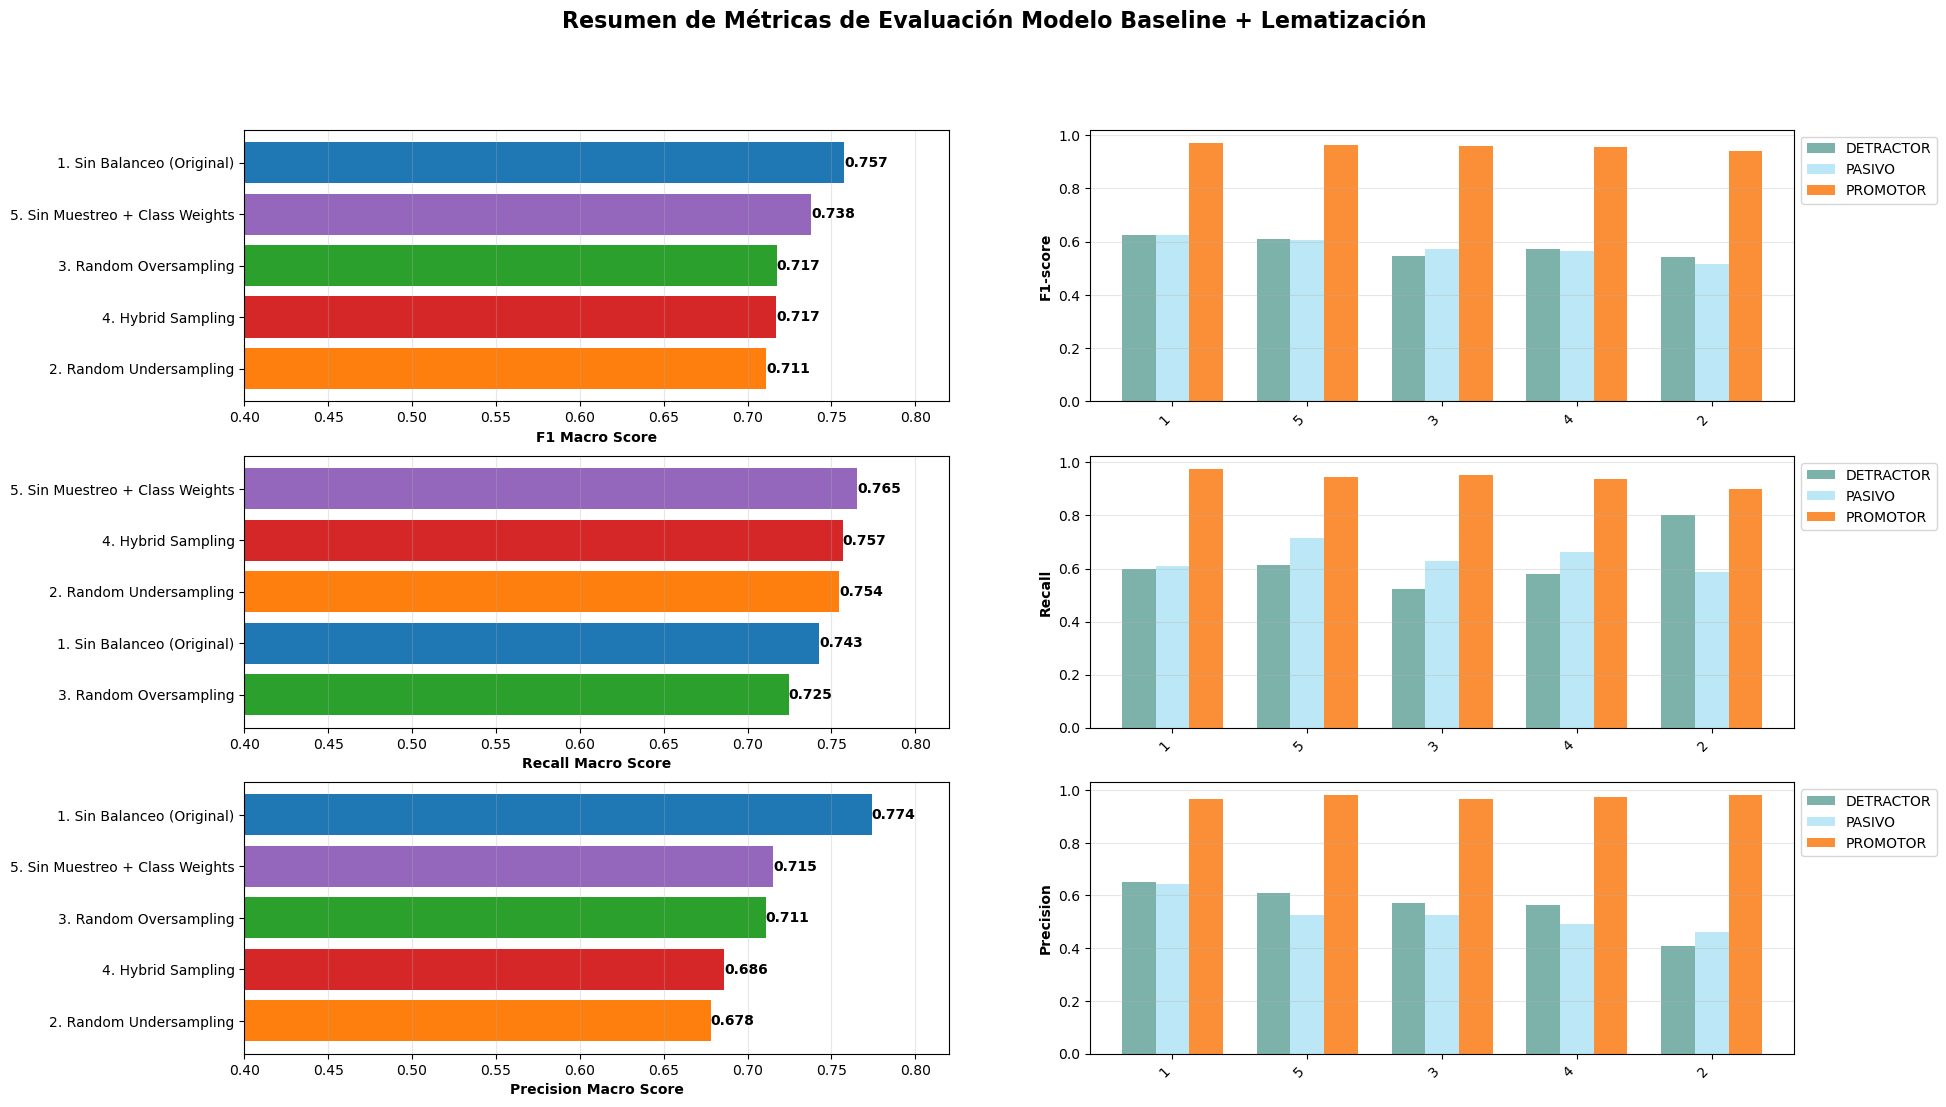
  • Lematización Reduce las palabras a su forma base para disminuir la variabilidad.
  • Arquitectura Baseline Se utiliza la misma arquitectura que el modelo baseline.

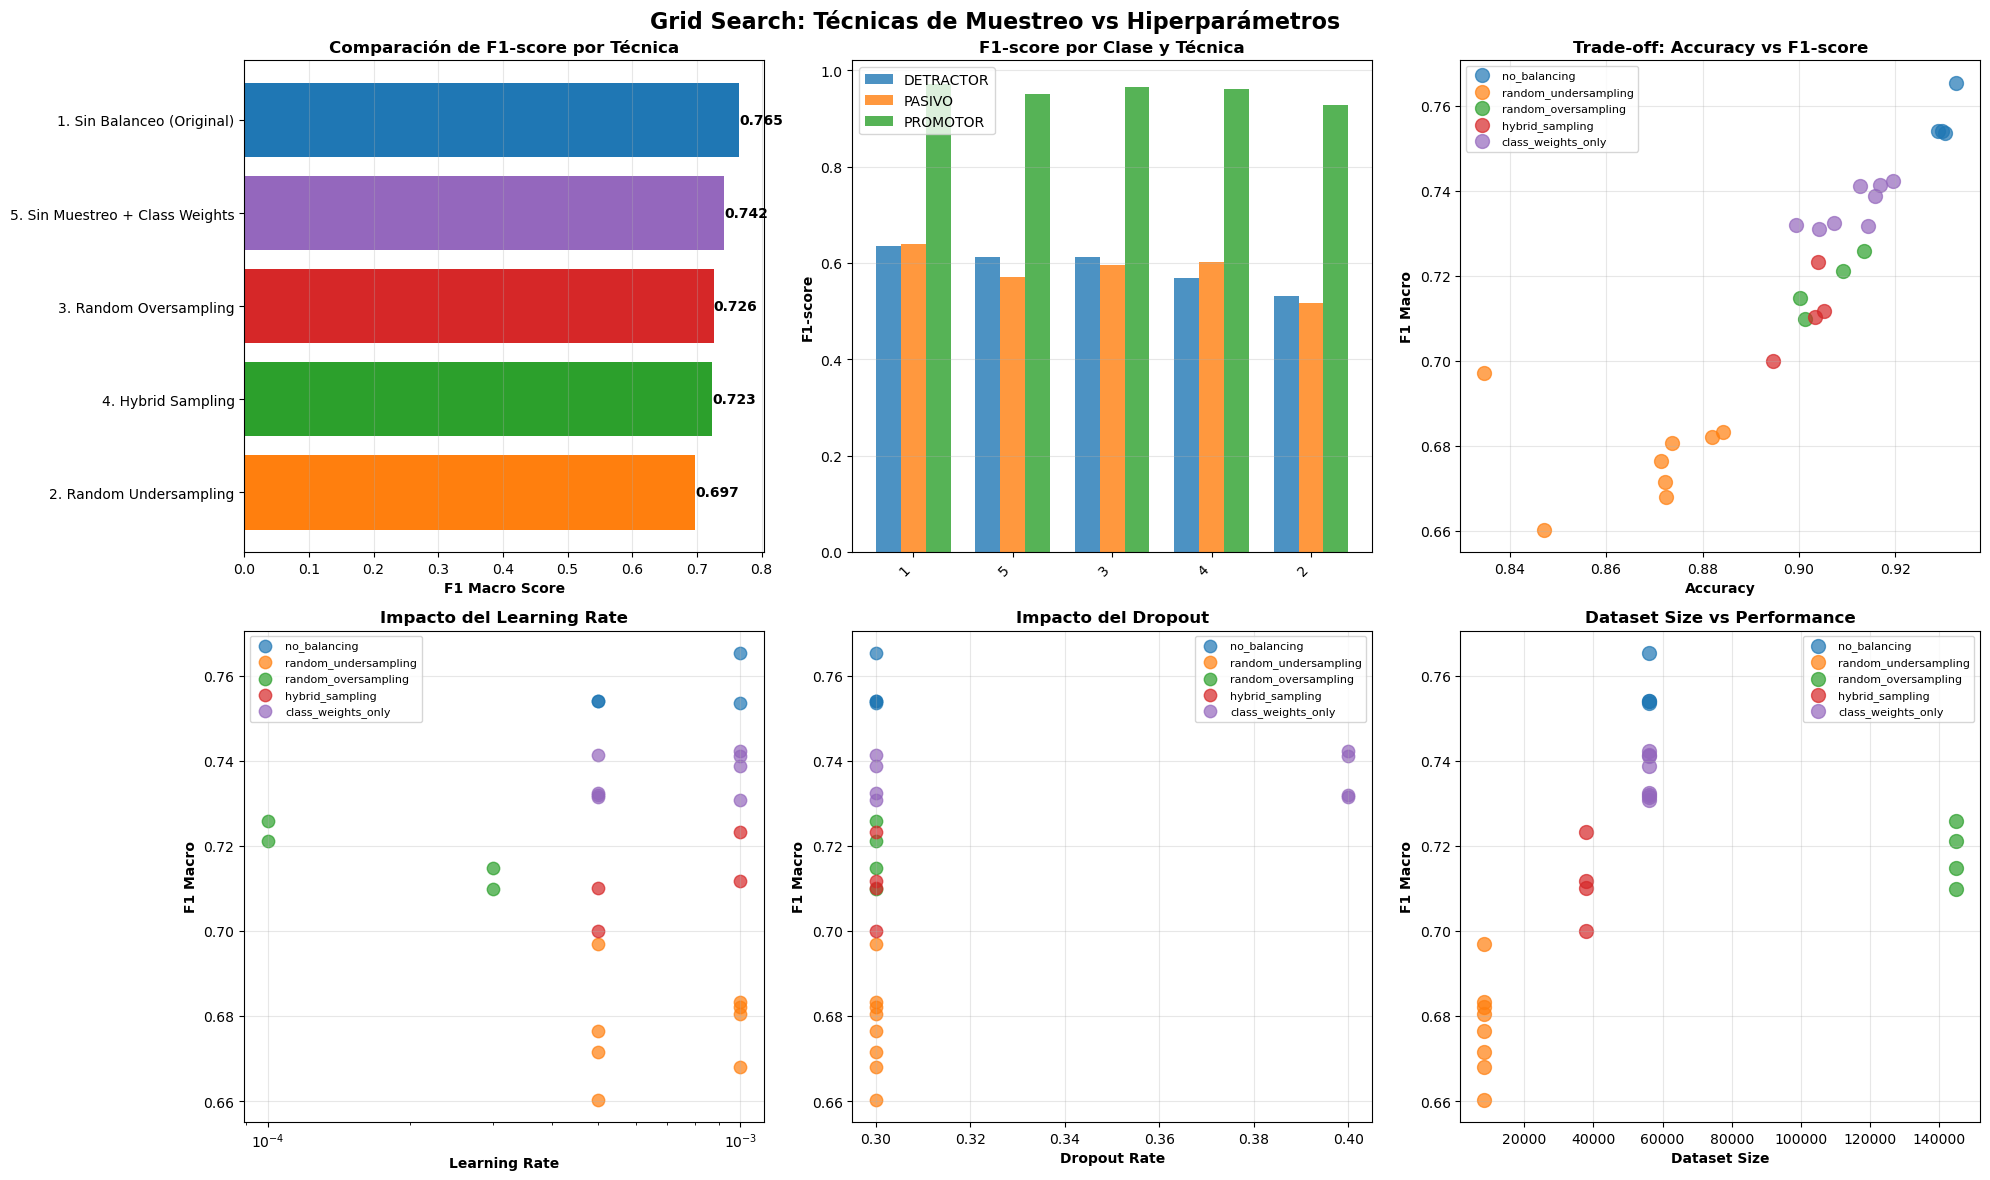
Grid Search Lematización + Baseline
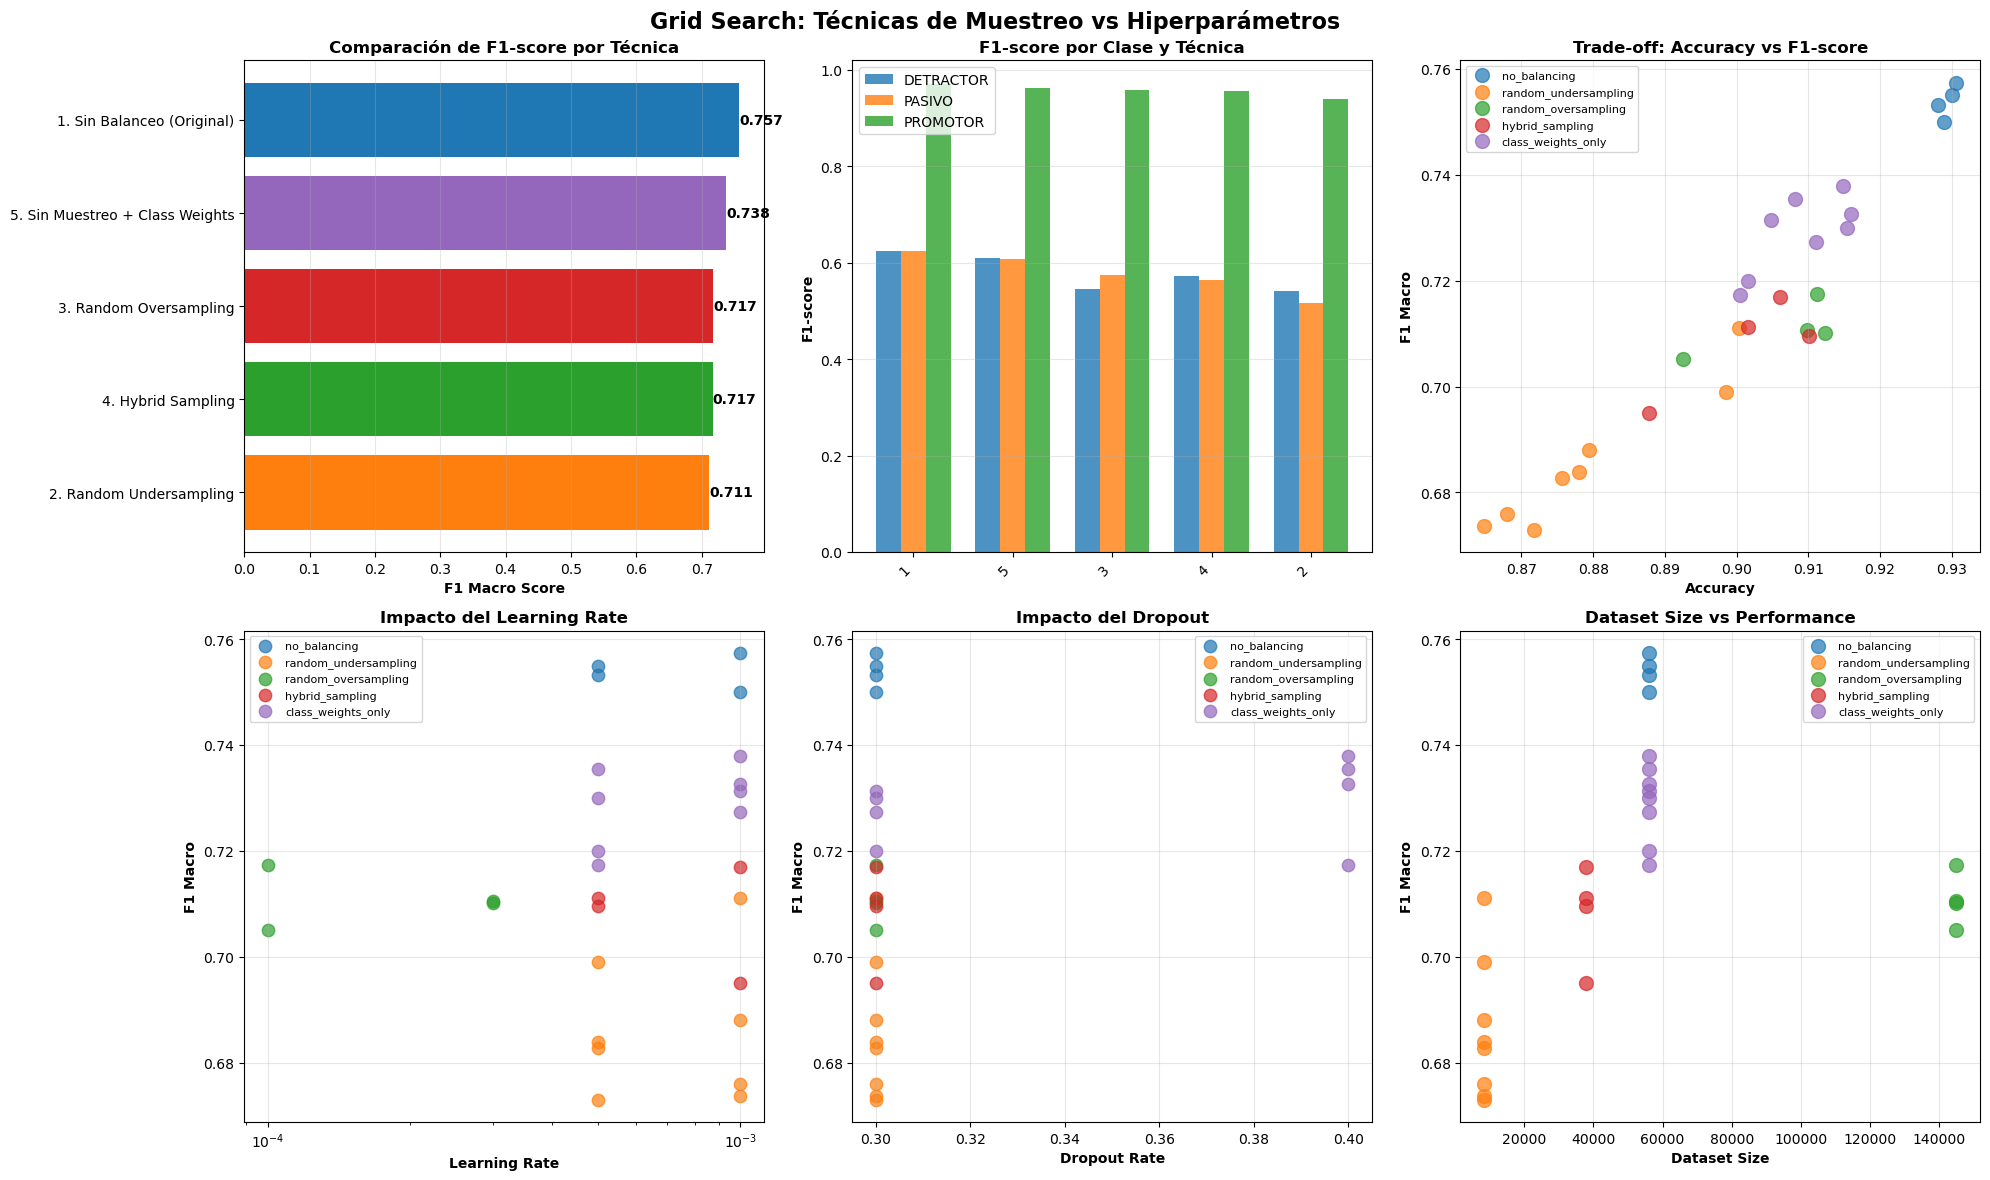
Métricas Lematización + Baseline
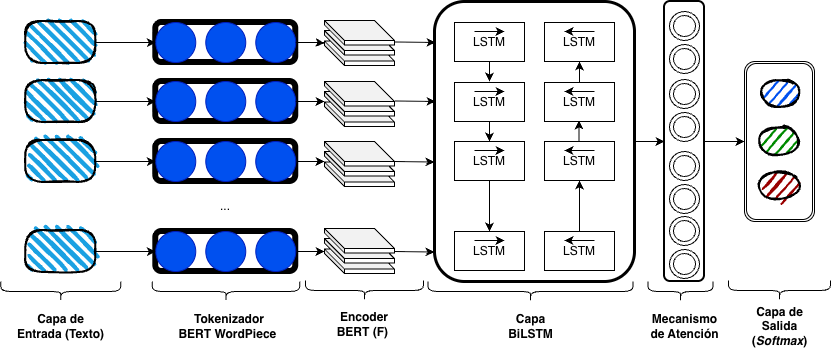
Modelo Híbrido
Modelo Híbrido

  • Tokenización del texto de entrada, mediante el tokenizador WordPiece específico de BETO.
  • Embeddings preentrenados utilizando BETO para capturar representaciones semánticas ricas.
  • Arquitectura Baseline Utiliza la misma arquitectura que el modelo baseline.

Comparación Baseline vs Híbrido

Aspecto Baseline BERT Híbrido
Embeddings Aprendidos desde cero (128d) BERT preentrenado (768d)
Modelado secuencial BiLSTM + Attention BiLSTM + Attention
Parámetros BERT 0 110M (frozen, no entrenan)
Parámetros Entrenables ~4.2M ~2.5M (LSTM+Attention+FC)
Conocimiento previo No Sí (Wikipedia, corpus español)
Velocidad entrenamiento Rápido Medio (forward de BERT + train LSTM)

Métricas Híbrido

Fine-Tuning con BETO
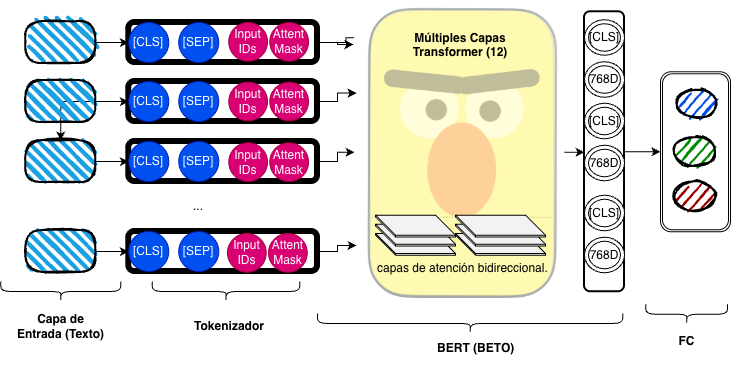
Fine-Tuning con BETO

  • Tokenización del texto de entrada mediante el tokenizador WordPiece específico de BETO.
  • Modelo BETO completo Se utiliza todo el modelo BETO, permitiendo que todos sus parámetros se ajusten durante el entrenamiento.

Métricas Macro Fine-Tuning BETO

Técnica F1 Recall Precision
Sin Balanceo (LR = 2e-5) 0.8022 0.7880 0.8176
Sin Balanceo (LR = 5e-5) 0.7995 0.7856 0.8144
Class Weights (LR = 2e-5) 0.7939 0.7977 0.7904
Class Weights (LR = 5e-5) 0.7927 0.7999 0.7862
Híbrido (LR = 2e-5) 0.7733 0.8063 0.7457
Híbrido (LR = 5e-5) 0.7704 0.7982 0.7501
Oversampling (LR = 5e-5) 0.7715 0.8049 0.7437
Oversampling (LR = 2e-5) 0.7640 0.7895 0.7421
Undersampling (LR = 5e-5) 0.7692 0.8135 0.7392
Undersampling (LR = 2e-5) 0.7562 0.8218 0.7099

Observaciones Fine-Tuning BETO

  • Mejor F1 y Precisión: El modelo sin balanceo con una tasa de aprendizaje de 2e-5 logró el mejor F1 (0.8022) y precisión (0.8176).
  • Mejor Recall: El modelo con undersampling y una tasa de aprendizaje de 2e-5 alcanzó el mejor recall (0.8218), crucial para identificar detractores, sin embargo, con una precisión más baja (0.7099)
  • Class Weights: Los modelos con pesos de clase muestran un equilibrio entre recall y precisión, siendo una buena opción para balancear ambos aspectos.

Métricas Fine-Tuning BETO

Métrica Sin Balanceo (2e-5) Sin Balanceo (5e-5) Class Weights (2e-5) Class Weights (5e-5)
F1 Prom 0.9785 0.9783 0.9765 0.9762
F1 Pas 0.7052 0.6979 0.6910 0.6839
F1 Det 0.7228 0.7221 0.7143 0.7178
Rec. Prom 0.9836 0.9834 0.9745 0.9748
Rec. Pas 0.6824 0.6741 0.7065 0.6783
Rec. Det 0.6978 0.6993 0.7122 0.7468
Prec. Prom 0.9735 0.9733 0.9786 0.9777
Prec. Pas 0.7296 0.7233 0.6762 0.6897
Prec. Det 0.7496 0.7465 0.7164 0.6911

Observaciones Métricas por Clase Fine-Tuning BETO

  • Desempeño por Clase: El modelo sin balanceo muestra un desempeño significativamente superior en la clase Promotor en comparación con las otras clases.
  • Recall Detractor: Los modelos con class weights mejoran el recall para la clase Detractor, lo cual es crucial para identificar clientes insatisfechos.
  • Precisión Pasivo: La precisión para la clase Pasivo es consistentemente más baja en todos los modelos, indicando un desafío en clasificar correctamente esta categoría.

COMPARACIÓN DE MODELOS

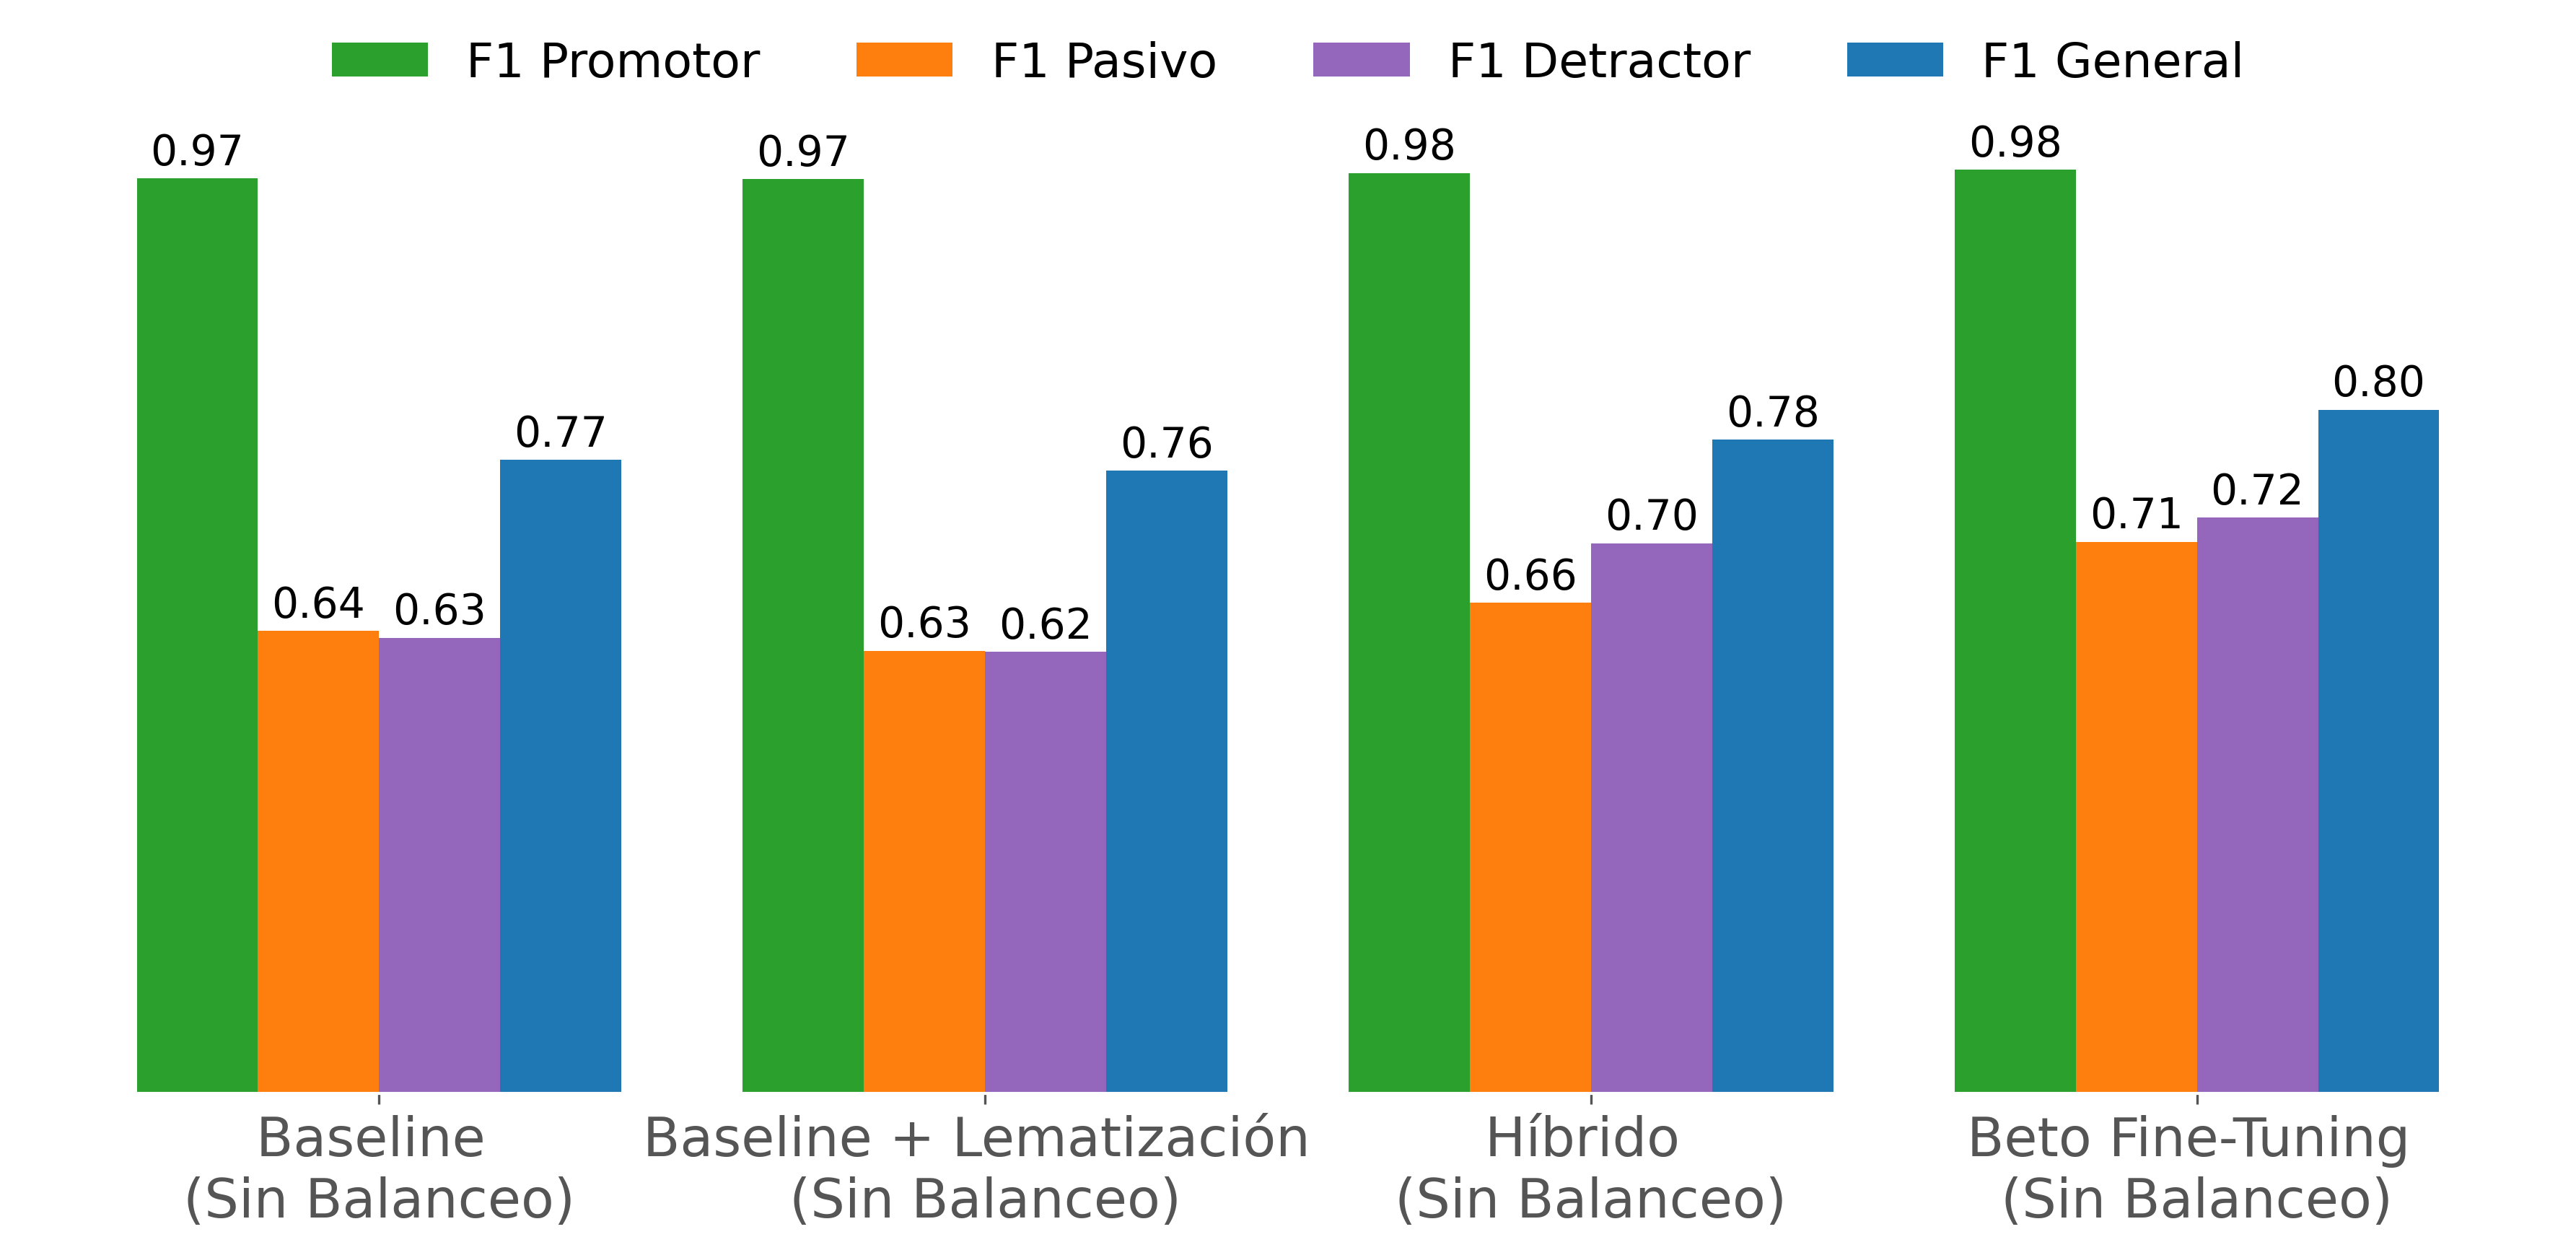
F1 entre arquitecturas

Variaciones de F1

  • BETO Fine-Tuning: Muestra la mejor puntuación F1 macro, destacando su eficacia en la clasificación de sentimientos en datos de NPS.
  • Modelos Híbridos y Baseline: Aunque no alcanzan el rendimiento de BETO, los modelos híbridos y baseline con lematización ofrecen mejoras significativas sobre el baseline simple.

Métricas para fine-tuning BETO
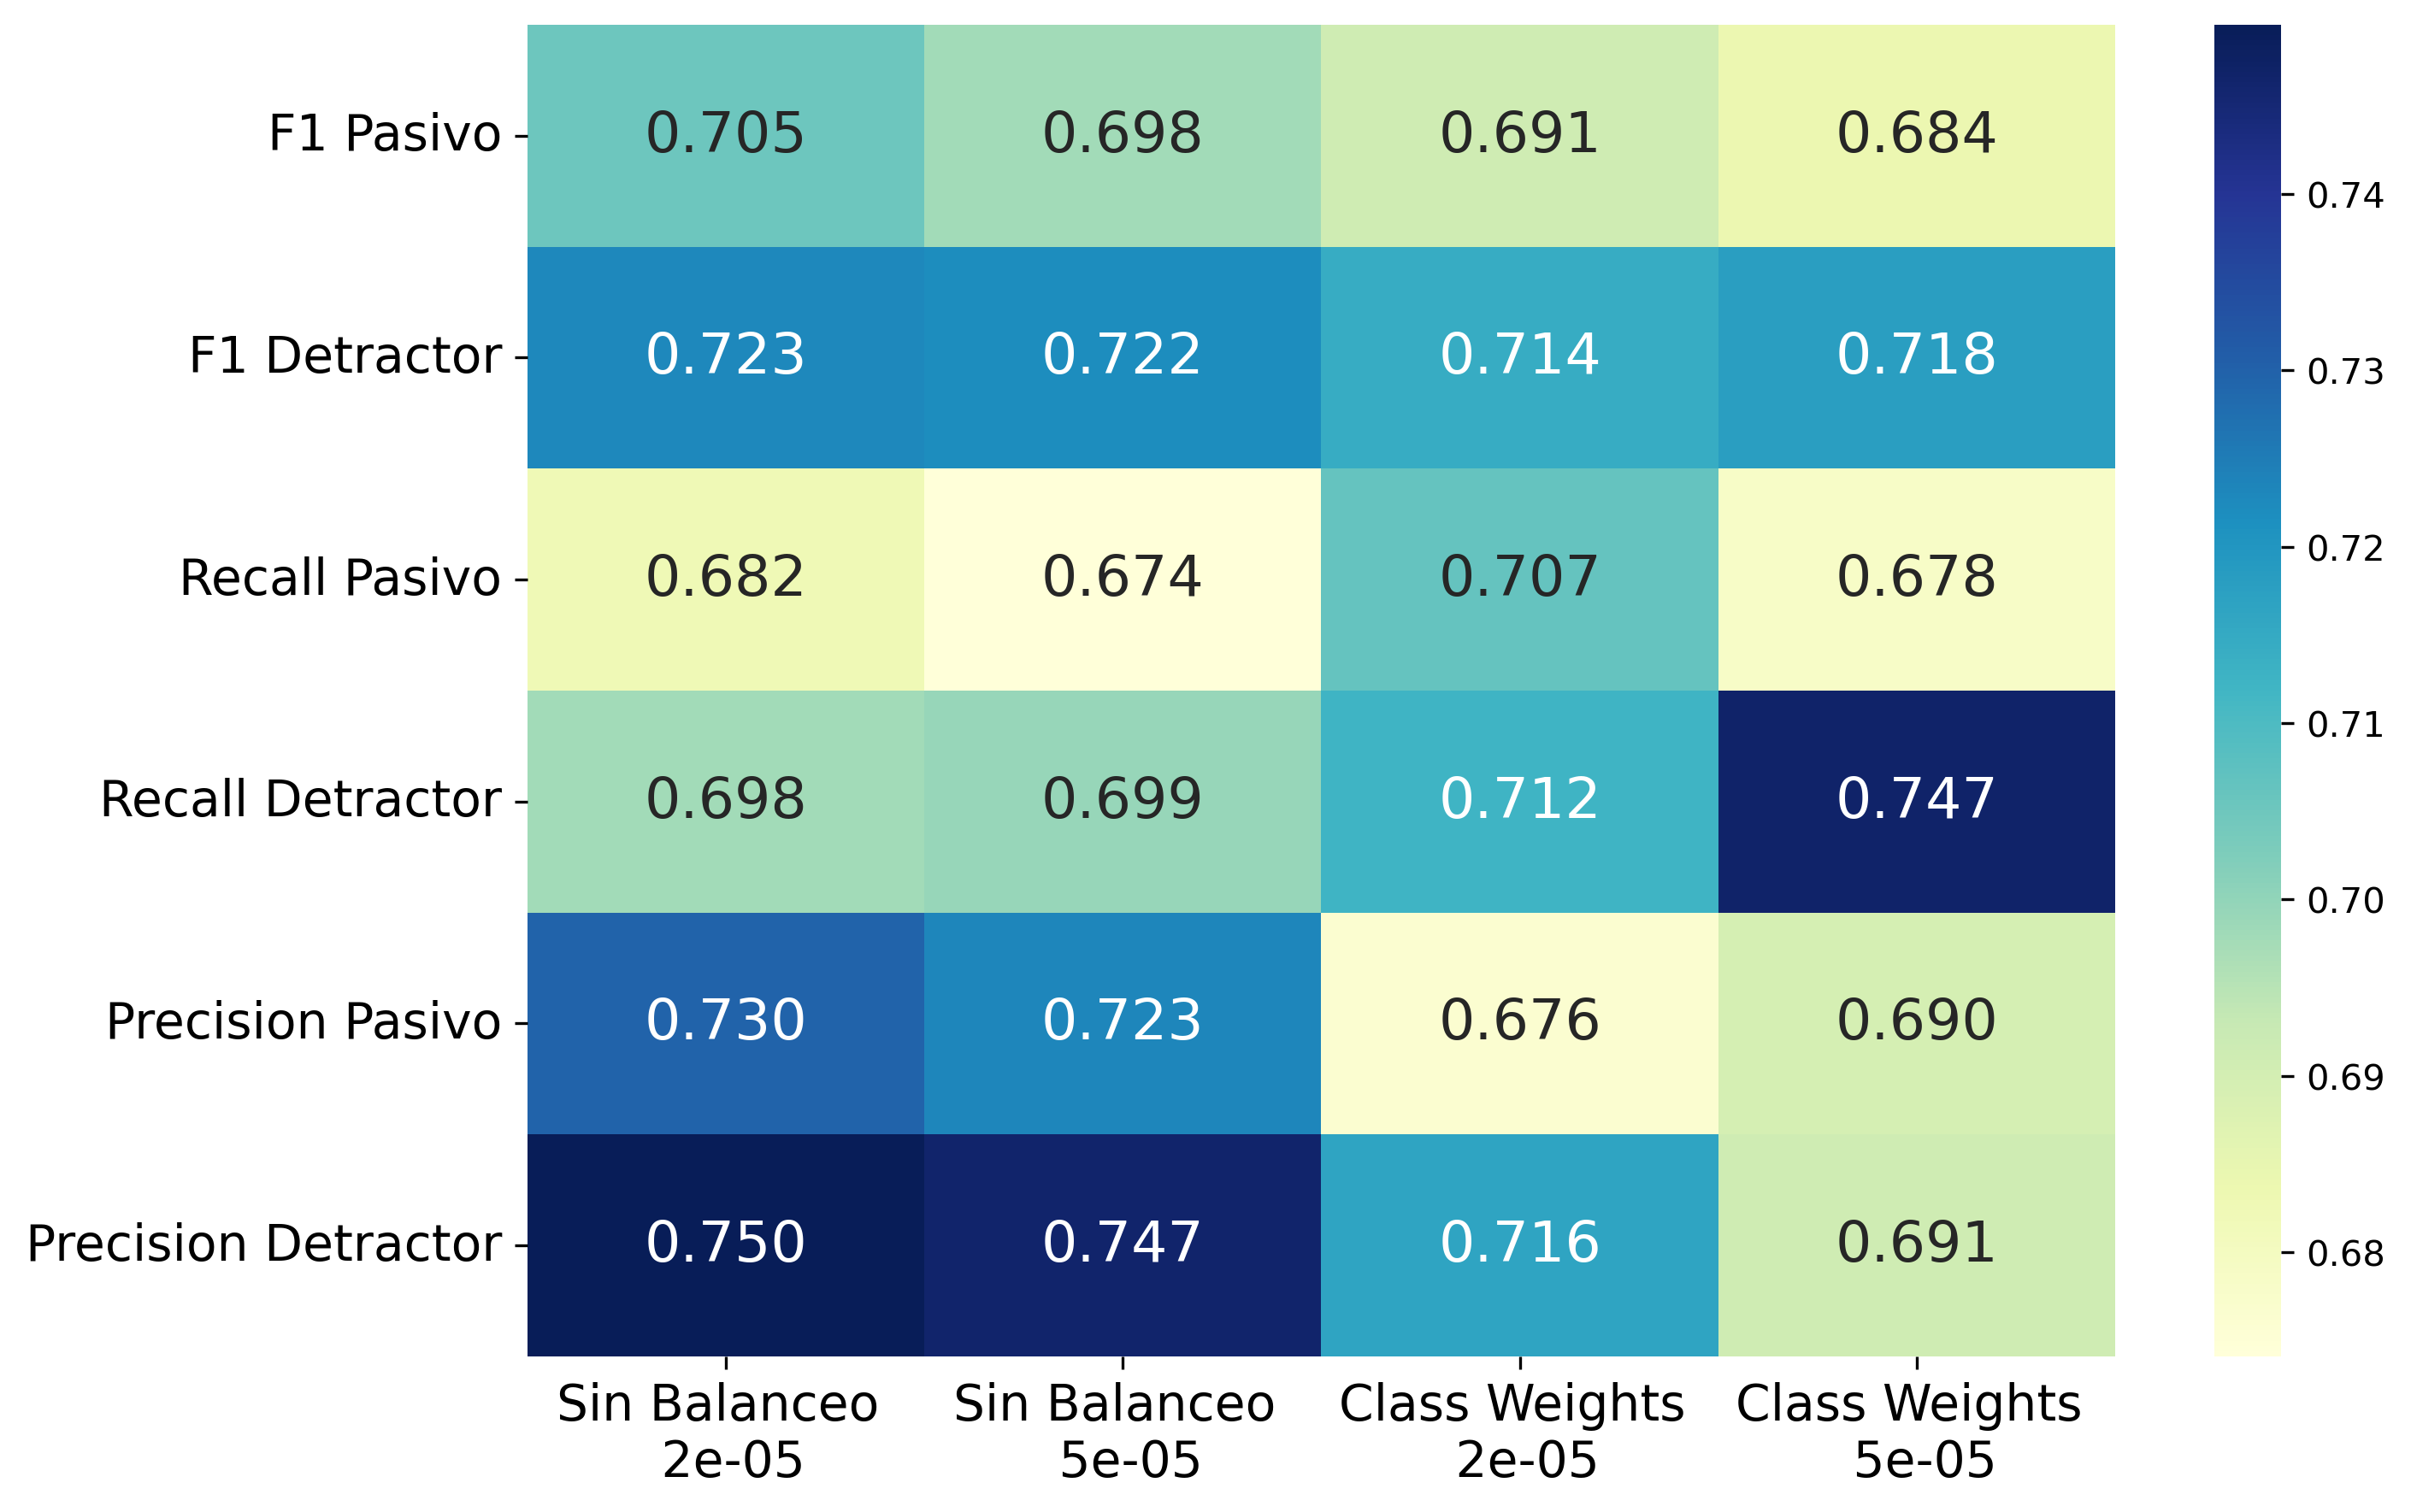
Análisis de Métricas y Matriz de Confusión

  • Heatmap de Métricas: Permite visualizar el rendimiento detallado de cada modelo en términos de F1, Recall y Precisión para cada clase.
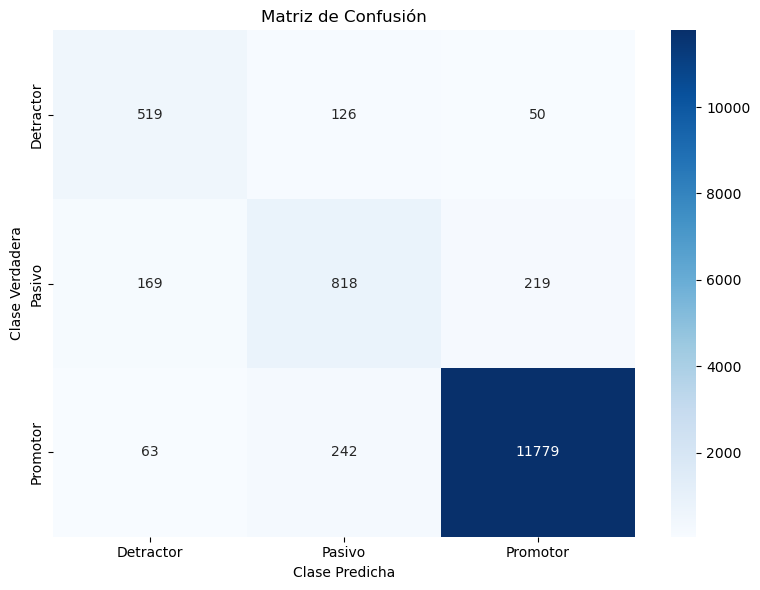
  • Matriz de Confusión: Destaca la capacidad del modelo para clasificar correctamente las instancias, especialmente en la clase Detractor, que es crucial para el objetivo del proyecto.

CONCLUSIONES

Conclusiones

  • El modelo Fine-Tuned Beto logró un mayor performance que las otras arquitecturas en todas las métricas evaluadas, alcanzando un mejor desempeño a nivel macro y por clase.

  • El modelo Fine-Tuned BETO con Class Weights se establece como la alternativa más adecuada para el despliegue, logrando el equilibrio óptimo entre un alto Recall para la Clase Detractor (en línea con el enfoque Omotenashi) y un rendimiento general estable.

  • La lematización no mostro mejoras en el desempeño del modelo baseline, sugiriendo que la reducción de variabilidad en las palabras no siempre conduce a mejores resultados en tareas de clasificación de texto.

BONUS: Aplicación con Reviews de Google

Aplicación Práctica

Detractor

Text: No crean en las opiniones están borrando las malas reseñas 1000 veces Metro el del condado nunca atiende aquí Predicted label: DETRACTOR with confidence 0.9980 CALIFICACION: 1

Promotor

Text: Excelente atención rápides en el mantenimiento vehicular Predicted label: PROMOTOR with confidence 0.9957 CALIFICACION: 5

Detractor

Text: Terrible la atención, dañaron el radio del carro, la peor experiencia. No quiero volver más nunca Predicted label: DETRACTOR with confidence 0.9981 CALIFICACION: 1

Pasivo

Text: Algo extraño, buscábamos el corolla cross, de contado no puedes comprarlo porque no está disponible, pero con su sistema “toyota siempre nuevo” ahí si. Es decir, prefieren que te endeudes para nunca terminar de pagar un auto en lugar de que te lo lleves a casa siendo completamente tuyo. Predicted label: PASIVO with confidence 0.9664 CALIFICACION: 3

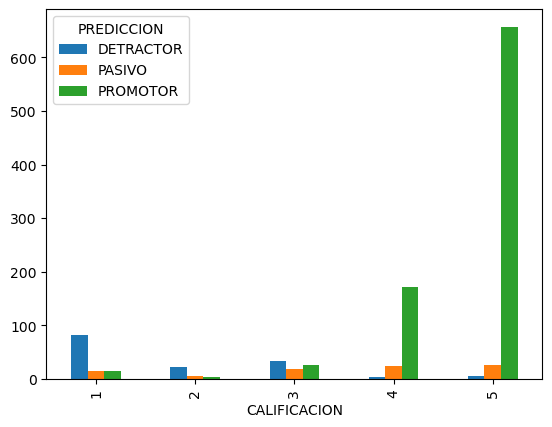
Distribución de predicciones

GRACIAS!

¡Gracias por su atención!